← Alle artikelen
GEO oktober 2026: wat wij als GEO agency zien gebeuren bij AI-modellen
22 oktober 2026 · · 8 min leestijd
Wildbos is een GEO agency. Sinds juli stellen we koopvragen aan ChatGPT, Gemini, Claude, Perplexity en vier andere AI-assistenten, en we bewaren elk antwoord met de bronnen erbij. Inmiddels zijn dat er 58.272. Daarnaast loggen we op twee sites elk bezoek van een AI-crawler.
Dit maandrapport gaat niet over hoe merken scoren. Het gaat over de modellen zelf. Waar halen ze hun informatie vandaan, hoe verschillen ze van elkaar, en hoe vaak komen hun crawlers langs?
In het kort
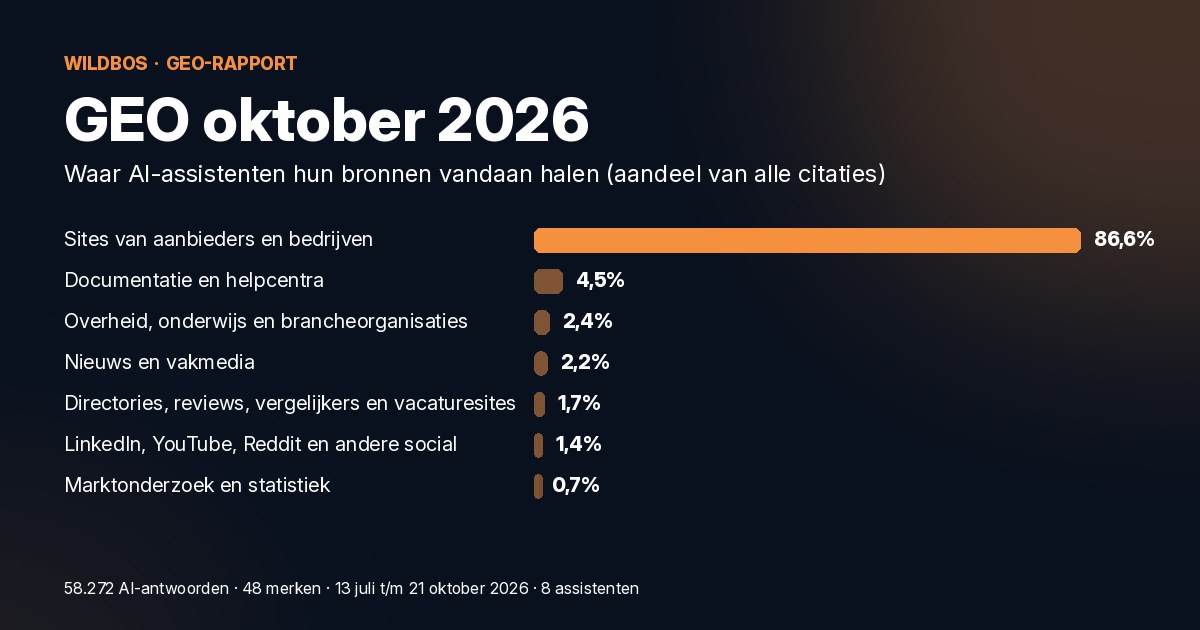
AI-assistenten bouwen hun antwoord vooral uit de sites van de partijen waar de vraag over gaat. Van de 403.692 citaties in onze metingen ging 86,6% naar sites van aanbieders en bedrijven.
| Soort bron | Aandeel citaties |
|---|---|
| Sites van aanbieders en bedrijven | 86,6% |
| Documentatie en helpcentra | 4,5% |
| Overheid, onderwijs en brancheorganisaties | 2,4% |
| Nieuws en vakmedia | 2,2% |
| Directories, reviews en vergelijkers | 1,7% |
| LinkedIn, YouTube, Reddit en andere social | 1,4% |
| Wikipedia | 0,3% |
De verdeling is scheef. De bovenste 1% van de 27.786 domeinen kreeg 41,2% van alle citaties. Wie in een sector de bekende bron is, wordt steeds opnieuw gepakt. Voor een GEO agency betekent dat: de eigen site van een bedrijf is het belangrijkste werkterrein, niet een lijstje externe plekken.
In elke sector zijn 8 tot 10 van de 10 meest geciteerde domeinen sites van aanbieders. Wat verschilt, is de tweede bron en de taal.
| Sector | Aanbieders | Grootste andere soort | .nl-domeinen |
|---|---|---|---|
| Software en SaaS | 83,8% | Documentatie en helpcentra, 7,8% | 7,7% |
| Letselschade en juridisch | 88,9% | Overheid en beroepsorganisaties, 4,6% | 86,0% |
| Marketing, sales en AI-diensten | 92,7% | Nieuws en vakmedia, 2,2% | 32,6% |
| Training, coaching en onderwijs | 89,1% | Directories en vergelijkers, 4,7% | 75,6% |
| Industrie, logistiek en energie | 88,4% | Marktonderzoek en statistiek, 4,7% | 9,1% |
Bij software beantwoordt AI een vraag graag met de handleiding of het helpcentrum van een platform. In training en coaching wegen vergelijkers zwaarder; Springest was daar het grootste publieke platform. In de industrie haalt AI opvallend vaak marktonderzoeksrapporten aan. En letselschade is het meest geconcentreerd: de tien grootste domeinen kregen samen 22,2% van de citaties, bijna allemaal Nederlandstalig.
Marketing en AI-dienstverlening is het tegenovergestelde: 6.146 verschillende domeinen, en de top 10 haalt maar 8,6%. Daar is nog niemand de vaste bron.
Dezelfde vraag levert per assistent andere bronnen op. Voor een eerlijke vergelijking tellen hier alleen de vier merken die we sinds 31 augustus op alle acht assistenten meten.
| Assistent | Bronnen per antwoord | .nl-bron bij NL-vraag | Zelfde bronnen als vorige keer |
|---|---|---|---|
| Perplexity | 16,1 | 37,0% | 44,0% |
| Grok | 12,4 | 29,1% | 33,5% |
| Claude | 5,4 | 43,1% | 31,1% |
| ChatGPT | 5,3 | 52,1% | 38,3% |
| Mistral | 5,3 | 50,2% | 53,8% |
| DeepSeek | 4,9 | 48,7% | 57,5% |
| Meta AI | 4,7 | 48,9% | 59,1% |
| Gemini | 4,5 | 47,1% | 59,8% |
Perplexity en Grok werken met veel meer bronnen dan de rest. Nederlandse vragen krijgen lang niet altijd Nederlandse bronnen: bij Grok kwam 29,1% van een .nl-domein. En de bronnen wisselen sterk. Stel je Claude dezelfde vraag opnieuw, dan is gemiddeld 31,1% van de domeinen hetzelfde als de vorige keer.
Assistenten delen ook weinig met elkaar. Kregen ze dezelfde vraag op dezelfde dag, dan deelden twee assistenten gemiddeld 25,5% van hun domeinen. 75,6% van de domeinen werd door maar één assistent gebruikt. Een GEO agency die alleen ChatGPT meet, ziet dus maar een klein stuk van het beeld.
AI-bedrijven halen veel vaker pagina's op om te trainen dan om een vraag te beantwoorden. Op twee sites telden we van 18 september tot en met 21 oktober 31.475 verzoeken van AI-crawlers: 69,4% om te trainen, 21,8% om een zoekindex te vullen en 8,8% om live een pagina op te halen omdat iemand op dat moment iets vroeg.
| Bot | Doel | Per site per dag | Terug na |
|---|---|---|---|
| Meta-ExternalAgent | trainen | 217,3 | 2 dagen |
| PerplexityBot | indexeren | 47,6 | 2 dagen |
| OAI-SearchBot (OpenAI) | indexeren | 43,1 | 1 dag |
| ClaudeBot (Anthropic) | trainen | 40,7 | 1 dag |
| Amazonbot | trainen | 23,5 | 7 dagen |
| ChatGPT-User | live ophalen | 13,3 | 1 dag |
"Terug na" is de mediaan van het aantal dagen tot dezelfde bot dezelfde pagina opnieuw ophaalt. Meta is verreweg de drukste crawler. ChatGPT-User en Claude-User halen elk zo'n 13 keer per site per dag live een pagina op, het dichtst dat je komt bij "iemand vroeg een assistent naar dit onderwerp".
Wat de crawlers laten liggen, zegt ook iets. Beide sites hebben een llms.txt, het bestand dat vaak wordt aangeraden om AI te vertellen wat er op een site staat. In de hele periode vroeg geen enkele AI-crawler dat bestand op. robots.txt werd 1.677 keer opgehaald en de sitemap ook geregeld. Wie AI wil helpen, zorgt dus eerst dat robots.txt crawlers toelaat en dat de sitemap klopt.
Een model weet uit zichzelf alleen wat er tot zijn kennisgrens in de trainingsdata zat. Bij de versies die wij meten, loopt dat van oktober 2023 (GPT-4o mini) tot februari 2026 (GPT-5.6 Luna). Alles daarna moet een assistent live opzoeken. Wat er vandaag op je site staat, bepaalt dus mee wat AI morgen over je zegt.
Modellen worden ook snel vervangen. Alle tien versies die we meten, hebben inmiddels een opvolger, en tussen twee versies zit meestal zo'n vier maanden (eigen berekening uit de releasedatums op OpenRouter). Wat een assistent vandaag over je weet, staat dus niet vast.
Op het hele internet groeit het crawlen. Volgens Cloudflare ging in juni 2026 52% van de crawlerverzoeken naar AI-training, tegen 22% in het voorjaar van 2025, terwijl Google nog steeds zo'n 88% van het terugverwezen verkeer levert. Fastly zag dat de crawler van Meta 60% van het AI-crawlerverkeer voor zijn rekening nam. Dat klopt met ons eigen logboek.
En onze markt is niet de Amerikaanse. In een onderzoek van Ahrefs over 9.671.806 antwoorden noemde 36,67% YouTube als bron en 8,81% Reddit. In onze metingen stond YouTube in 1,0% van de antwoorden met bronnen en Reddit in 0,4%. Een GEO agency die een Amerikaans draaiboek kopieert, zet dus in op de verkeerde plekken.
De cijfers komen uit het GEO-platform van Wildbos. Per merk stellen we een vaste set koopvragen aan tot acht AI-assistenten via hun API, deels met webzoeken, en bewaren we de antwoorden met bron-URL's. We meten dus niet in de apps zelf. De periode loopt van 13 juli tot en met 21 oktober 2026, met 48 merken, vooral Nederlandse B2B, deels met Engelse vragen. Sectoren met te weinig antwoorden laten we weg.
Soorten bronnen delen we in met vaste regels per domein; wat nergens onder valt, telt als aanbieder. Sites van aanbieders noemen we nooit bij naam. Het crawlerlogboek komt van twee Nederlandse zakelijke sites, 18 september tot en met 21 oktober. Als GEO agency publiceren we dit rapport elke maand met dezelfde definities.
Een GEO agency zorgt dat AI-assistenten als ChatGPT, Gemini en Perplexity jouw bedrijf noemen als een koper een vraag stelt. Dat begint met meten welke bronnen de AI in jouw sector gebruikt. Daarna volgt het werk aan je site, je content, je vermeldingen en je reviews. Een goede GEO agency laat elke maand zien wat er veranderde.
In onze metingen vooral van de sites van aanbieders zelf: 86,6% van 403.692 citaties. Documentatie en helpcentra, overheid en brancheorganisaties, vakmedia en directories volgen op grote afstand. Wikipedia was goed voor 0,3%.
Op de twee sites die we volgen, kwam de crawler van Meta gemiddeld 217 keer per dag. De crawlers van OpenAI, Perplexity en Anthropic kwamen elk 41 tot 48 keer per dag en haalden dezelfde pagina meestal binnen één of twee dagen opnieuw op.
Wil je weten welke bronnen AI in jouw sector gebruikt? De gratis GEO-scan laat het per assistent zien. Zoek je een GEO agency die het werk ook uitvoert, dan lees je daar hoe we dat doen.
Meet het gratis en zie per assistent welke sites het antwoord bepalen.
Verder met GEO
Zie bij welke koopvragen AI jou noemt en bij welke je concurrent. Credits vanaf €25, pay as you go.
Bekijk het platformGeen tijd? Wij doen het werk. Je website, je content, de pers en je reviews.
Zo werkt done-for-youLeer zelf hoe AI kiest wie het noemt. Een praktische training voor marketeers.
Bekijk de training